2024/02/15
2022/07/04
將 guest 移至esxi後 因為需要定時重開几還原
記錄一下設定
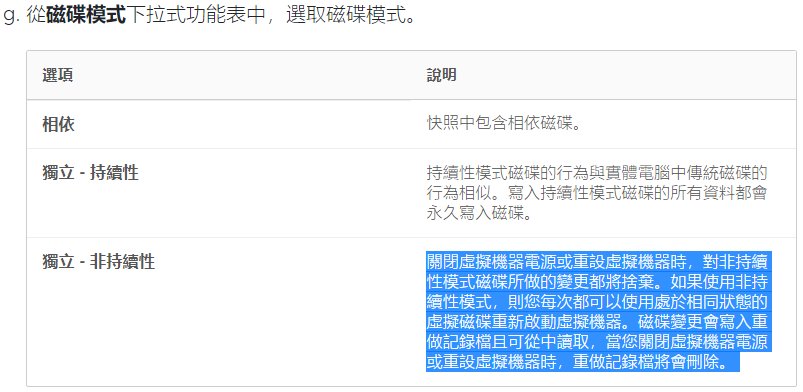
首先將 hd 模式設為 獨立-非持續性
說明如下
esxi啟動 SSH 以SSH登入
接下來取得vmid
vim-cmd vmsvc/getallvms
https://anby.org/index.php/archives/182/
2021/06/06
安裝jitsi的流程記錄一下 ubuntu 20.04
os安裝好後
apt update
apt upgrade -y
在DNS上設定好server的name
接下來
apt install curl gnupg
curl https://download.jitsi.org/jitsi-key.gpg.key | sudo sh -c 'gpg --dearmor > /usr/share/keyrings/jitsi-keyring.gpg'
echo 'deb [signed-by=/usr/share/keyrings/jitsi-keyring.gpg] https://download.jitsi.org stable/' | sudo tee /etc/apt/sources.list.d/jitsi-stable.list > /dev/null
sudo apt-get -y update
sudo apt-get -y install jitsi-meet
如果要使用letsencrypt
apt install certbot
/usr/share/jitsi-meet/scripts/install-letsencrypt-cert.sh
重啟nginx
到 https://servername
就可以使用了
letsencrypt要記得每三個月renew一次
或使用crontab
1 1 * * 6 /usr/bin/certbot renew
https://kafeiou.pw/2020/06/19/2489/
https://campus-xoops.tn.edu.tw/modules/tad_book3/page.php?tbdsn=1557
2020/11/08
今天記錄一下 librenms 中 weathermap的安裝
官方說明文件如下
https://docs.librenms.org/Extensions/Weathermap/
安裝完後建立圖形的第一個步驟記得要先到 Map Properties
設定
Output Image Filename
Output HTML Filename
否則會看不到網頁及圖形
2020/08/19
2019/10/22
目前我在index set的設定是留180天
超過的delete
不過我會手動去close index
只留約一個月的資料 查詢效率比較好
可是今天發現index超過了180天但系統並沒有去delete
我不確定是不是因為我手動去close的關係
如果真的是如此的話 那政策就要改成定時close
然後再手動去delete了
手動砍的shell如下
每天找出最舊的index再砍掉
#!/bin/bash
del_idx=`/usr/bin/curl -u admin:password 'http://127.0.0.1:9200/_cat/indices/graylog*?v'|grep close|awk '{print $2}'|sort -rn -t_ -k 2|tail -n 1`
/usr/bin/curl -XDELETE "http://localhost:9200/$del_idx/"
用crontab 來做吧
2018/06/10
2017/10/24
2017/05/04
2014/12/11
2014/08/14
會造成host os的down g
目前已詢問原廠是否有解決方案
考慮最差的情況應該就是拿一台机器把iscsi捉進來
再用nfs share出來了
因為容量超過2T所以必須使用之前的方法來處理
另外mount -t xfs /dev/sdb1 /mnt這個動作如果寫在/etc/rc.local
會因為執行太早網路還沒起來而無法成功
因此使用另一個方法
把開机後執行的指令放到crontab 裡
@reboot /root/0814test
0814test的內容如下
#!/bin/bash
/usr/bin/sleep 10
/usr/bin/mount -t xfs /dev/sdb1 /mnt
目前測起來工作是正常
只是nfs如果斷線重連
guest os還是有可能有問題需要重開
跟之前的預期有落差
2014/05/28
如下
/etc/cron.daily/mlocate:
Warning: /var/lib/mlocate/daily.lock present, not running updatedb.
run-parts: /etc/cron.daily/mlocate exited with return code 1
查了一下才知道這個訊息跟nfs有關
http://jonmccune.wordpress.com/2010/08/11/warning-varlibmlocatedaily-lock-present-not-running-today/
想到前几天才把一台nfs下架
雖然在/etc/pve/storage.cfg裡已經update了
但/etc/mtab還沒清掉
難怪這几天下df指令會一直hang住
2014/03/31
以下方法將每15秒執行一次
1.編輯crontab
# crontab -e
QUOTE:
* * * * * /bin/date >>/tmp/date.txt
* * * * * sleep 15; /bin/date >>/tmp/date.txt
* * * * * sleep 30; /bin/date >>/tmp/date.txt
* * * * * sleep 45; /bin/date >>/tmp/date.txt
2.檢查結果
# tail -f /tmp/date.txt
說明:需要將 /bin/date 更換成你的命令即可
================================================
如果需要精確到每秒執行一次...則可以寫Shell 的方式運作
1.編寫shell腳本
# mkdir /root/bin
# vi /root/bin/time.sh
QUOTE:
#!/bin/sh
while [ true ]; do
/bin/sleep 1
/bin/date >>/tmp/date.txt
done
2.後台運行
# nohup /root/bin/time.sh &
3.確認每秒執行
# tail -f /tmp/date.txt
http://www.adj.idv.tw/html/32/t-76632.html